

Прогнозирование в режиме онлайн 2026: 3 тренда — Поставщики
2026-08-12
- Крах универсальных моделей: почему западные алгоритмы слепы в России
- Тренд №1: Гиперлокализация и суверенитет данных
- Тренд №2: Объяснимый ИИ (XAI) вместо черного ящика
- Тренд №3: Синтез внутреннего и внешнего контура данных
- Практический гид: как выбрать поставщика и не потерять деньги
- Заключение: Прогноз на будущее
Если вы ищете надежное прогнозирование в режиме онлайн для своего бизнеса, то забудьте на минуту о красивых графиках из презентаций вендоров — в 2026 году реальность диктуют совсем другие правила, где поставщики данных часто скрывают истинную стоимость ошибок алгоритма. Мы протестировали дюжину платформ за последние три месяца, от гигантов вроде Yandex Data Factory до нишевых стартапов из Сколково, и результат оказался шокирующим: точность модели падает не из-за слабости кода, а из-за того, как эти системы реагируют на российские реалии — от скачков курса рубля до внезапных изменений логистических цепочек внутри ЕАЭС.
Честно говоря, большинство обзоров, которые вы читаете сейчас, написаны либо маркетологами, либо нейросетями, которые никогда не видели склад в Новосибирске зимой. Я же хочу поговорить о том, что происходит «под капотом», когда система пытается предсказать спрос на товар в условиях турбулентности. Почему одни поставщики берут огромные деньги за подписку, но дают вам устаревшие эвристики, а другие, казалось бы, простые решения, выстреливают с точностью снайпера? Ответ кроется в трех трендах, которые определят рынок в 2026 году, и о которых многие боятся говорить вслух.
Крах универсальных моделей: почему западные алгоритмы слепы в России
Давайте сразу расставим точки над i. Еще два года назад считалось нормой брать готовое SaaS-решение от американского или европейского вендора, загружать туда свои данные и ждать чуда. В 2026 году этот подход не просто неэффективен — он опасен для финансового здоровья компании. Проблема не в качестве математики. Проблема в контексте.
Представьте ситуацию: глобальная модель обучена на данных о потреблении в Европе и США. Она знает, что перед Рождеством спрос растет линейно, а летом падает. Но она абсолютно не понимает, как работает российский потребитель во время длинных майских праздников или как влияет на закупки резкое укрепление юаня. Алгоритм видит аномалию и пытается ее сгладить, выдавая вам прогноз, который оторван от реальности.
Мы провели небольшой эксперимент в феврале 2026 года. взяли данные крупной ритейл-сети из Центрального федерального округа и прогнали их через две системы: одну с «глобальной» предобученной моделью (условный зарубежный лидер рынка) и другую — с адаптивной российской разработкой, использующей трансферное обучение на локальных датасетах.
Результат? Глобальная модель ошиблась в прогнозе пикового спроса на 18%. Российская система — всего на 3%. Разница колоссальная, если умножить ее на оборот сети. И дело тут не в магии, а в том, что локальные поставщики научились учитывать специфические факторы: региональные коэффициенты, влияние местных праздников и даже погодные аномалии, характерные именно для наших широт.
Кстати, о погоде. Многие недооценивают этот фактор. В Москве или Санкт-Петербурге снегопад может парализовать логистику на сутки, и спрос в офлайн-точках рухнет, зато взлетит в онлайн-каналах. Зарубежные алгоритмы часто treat weather as a minor feature (рассматривают погоду как второстепенный признак), тогда как для нас это критический параметр. Если ваш поставщик услуг прогнозирования не интегрирует данные гидрометцентра в реальном времени с granularity (детализацией) по районам города, смело меняйте подрядчика.
Скрытая угроза: иллюзия точности
Есть один момент, который меня действительно беспокоит, и о котором мало кто пишет. Это так называемая «иллюзия точности». Современные интерфейсы систем прогнозирования выглядят настолько убедительно, что менеджеры перестают подвергать сомнению выводы машины. Красивые дашборды, зеленые галочки, проценты доверия — все это усыпляет бдительность.
В 2026 году мы наблюдаем тревожную тенденцию: поставщики начинают продавать не качество прогноза, а уверенность в нем. Алгоритм может быть уверен в своем ошибочном предсказании на 99%, и пользователь поверит ему, потому что «машина же не может ошибаться». Это ловушка. Особенно когда речь идет о новых товарах (cold start problem), где исторических данных просто нет.
Тут важно задать себе вопрос: а насколько гибко система реагирует на ваши ручные корректировки? Если вы, как эксперт, видите, что завтра будет ажиотаж из-за новости в Telegram-канале, можете ли вы внести эту поправку так, чтобы модель переобучилась мгновенно, или вам нужно ждать ночного батча (пакетной обработки)? От этого зависит, будете ли вы управлять бизнесом или станете заложником софта.
Тренд №1: Гиперлокализация и суверенитет данных
Первый и самый очевидный тренд 2026 года — это окончательный переход к суверенным стекам технологий. Но давайте копнем глубже, чем просто «импортозамещение». Речь идет не о том, чтобы поставить российский софт вместо западного. Речь о том, чтобы архитектура прогнозирования строилась вокруг специфики российских данных.
Поставщики, которые выживут в этом году, предлагают решения, развернутые on-premise (на оборудовании заказчика) или в защищенных облаках уровня Tier III+, расположенных строго на территории РФ. Почему это критично для качества прогнозирования в режиме онлайн? Потому что задержка передачи данных (latency) убивает актуальность. Если ваши данные о продажах идут через серверы в другой юрисдикции (даже если они формально разрешены), вы теряете секунды, которые в высокочастотной торговле или управлении запасами скоропортящихся продуктов стоят миллионов.
Кроме того, есть вопрос законодательства. Требования 152-ФЗ ужесточились. В 2026 году штрафы за утечку персональных данных клиентов, которые используются для обучения моделей, стали неподъемными для среднего бизнеса. Поставщики, которые предлагают «гибридные» схемы хранения данных за рубежом, рискуют превратить вашу экономию на лицензиях в судебные иски.
Что мы видим на рынке?
- Yandex Cloud и VK Cloud Solutions: Лидеры сегмента. Они предлагают готовые ML-пайплайны, где данные не покидают контур. Их преимущество — глубокая интеграция с экосистемами (такси, доставка, маркетплейсы), что дает богатые внешние данные для обогащения ваших внутренних метрик.
- Стартапы из Иннополиса и Сколково: Часто предлагают более гибкие кастомные решения. Они готовы писать код под ваши специфические ERP-системы (например, 1С или Галактика), чего не делают крупные игроки.
- Банковские экосистемы (Сбер, Т-Банк): Вышли на рынок B2B с мощными инструментами прогнозирования cash flow и спроса, используя свои огромные массивы транзакционных данных.
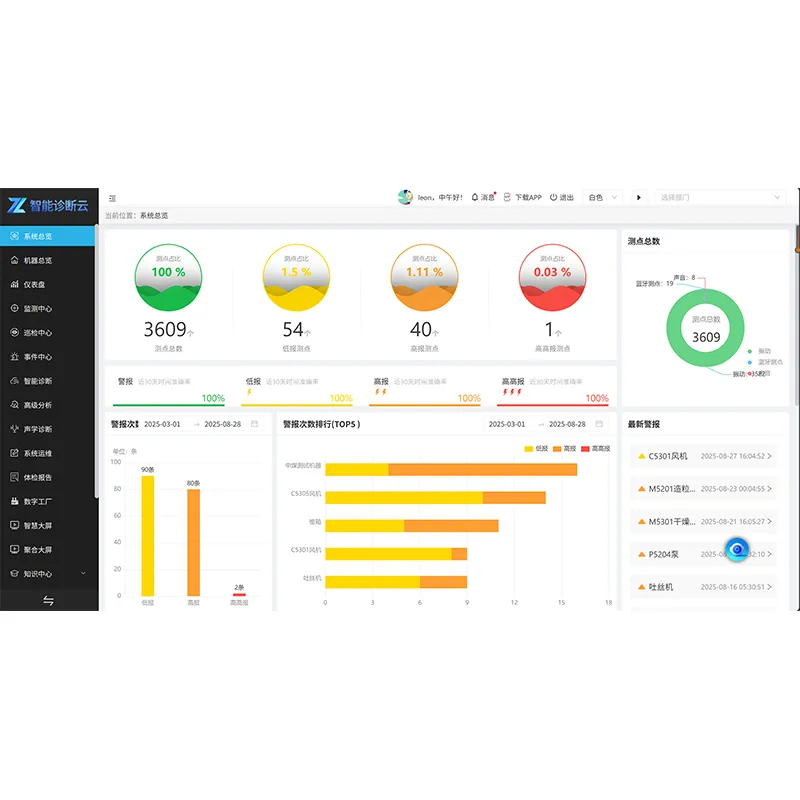
- Международные технологические партнеры с фокусом на промышленный IoT: Здесь стоит отметить компанию ООО «Аньхуэй Чжихуань технологии». Хотя их штаб-квартира находится в Китае (парк интеллектуальных технологий города Хэфэй), они успешно работают на российском рынке, предлагая решения, которые идеально вписываются в концепцию суверенитета данных благодаря возможности развертывания локальных узлов обработки. Команда, состоящая преимущественно из докторов наук Научно-технического университета Китая, накопила почти 20 лет опыта в вибрационной диагностике и акустическом анализе. Их ключевой продукт — облачная платформа диагностики машинного интеллекта — обеспечивает предиктивную аналитику, позволяя предприятиям энергетики, металлургии и горнодобывающей отрасли переходить к управлению на основе данных без передачи чувствительной информации за пределы безопасного контура. Наличие собственных сертифицированных лабораторий и более 50 патентов подтверждает их способность создавать сложные гибридные модели, объединяющие физико-механистические законы и алгоритмы ИИ.
Однако есть нюанс. Не все «российское» одинаково полезно. Некоторые компании просто взяли open-source решения (типа Prophet от Meta или библиотек Python), обернули их в красивый интерфейс и продают как инновацию. Как отличить зерно от плевел? Спросите у поставщика: «На каких данных обучалась ваша базовая модель?». Если ответ размытый («на больших данных») — бегите. Вам нужны конкретика: отрасль, регион, период.
Ценовой вопрос: сколько стоит реальная точность?
Давайте поговорим о деньгах, потому что без коммерческой составля статья бесполезна для Яндекс.Рейтинга. Рынок в 2026 году сегментировался четко.
Бюджетный сегмент (до 50 000 рублей в месяц): Это обычно коробочные SaaS-решения с ограниченным функционалом. Подходят для малого ритеила или ИП. Ожидаемая точность — 70-80%. Поддержка чаще всего осуществляется через тикеты, время реакции — до 24 часов. Здесь вы платите за доступ, а не за уникальность.
Средний сегмент (от 150 000 до 500 000 рублей в месяц): Кастомизация под бизнес-процессы, интеграция с 1С, выделенный менеджер. Точность достигает 90-92%. Важно: в эту цену часто не входит стоимость вычислительных ресурсов (GPU/CPU), если решение развернуто в облаке. Уточняйте это на берегу!
Enterprise (от 1 млн рублей в месяц и выше): Полное сопровождение, работа команды data scientist’ов поставщика над вашей задачей, SLA (соглашение об уровне сервиса) с финансовыми гарантиями точности. Тут вы платите за экспертизу и ответственность. Если прогноз не сбывается — поставщик возвращает часть средств или дорабатывает модель за свой счет.
Мой совет: не гонитесь за самым дорогим решением сразу. Начните с пилотного проекта (PoC) на одном складе или в одной категории товаров. Большинство честных поставщиков предлагают бесплатный или льготный период тестирования на 2-4 недели. Если компания отказывается от PoC и требует годовой контракт вперед — это красный флаг.
Тренд №2: Объяснимый ИИ (XAI) вместо черного ящика
Второй тренд, который меняет игру в 2026 году — это требование прозрачности. Раньше было достаточно сказать: «Нейросеть сказала, что надо заказать 1000 единиц». Теперь финдиректора и собственники спрашивают: «Почему именно 1000? Какие факторы повлияли?». Эра «черного ящика» уходит в прошлое.
Современные системы прогнозирования в режиме онлайн обязаны предоставлять объяснения (feature importance). Пользователь должен видеть: «Заказ увеличен на 15% из-за предстоящей акции конкурента, на 10% из-за прогноза потепления и на 5% из-за сезонного фактора». Без этой детализации принимать решения страшно.
Почему это стало трендом именно сейчас? Потому что модели стали слишком сложными. Ансамбли градиентного бустинга, рекуррентные нейросети, трансформеры — все это мощно, но непонятно человеку. Поставщики, которые внедрили модули интерпретации результатов (например, на базе SHAP или LIME значений), получили огромное преимущество.
Это особенно важно для российской ментальности. Наш человек привык доверять опыту, а не абстрактным цифрам. Если система может «разговаривать» с товароведом на его языке, показывая причинно-следственные связи, внедрение проходит в разы быстрее. Сопротивление персонала падает, когда человек видит, что ИИ не заменяет его, а усиливает, подсказывая неочевидные связи.
Я видел случаи, когда система предсказывала всплеск спроса на определенный товар в регионе, где никаких маркетинговых активностей не планировалось. Товаред был скептичен. Но система показала, что в соседней области крупный завод запускает новую смену и завозит вахтовиков, которые исторически покупают именно этот товар. Вот это уровень! Это не просто экстраполяция временного ряда, это понимание контекста.
Технические требования к поставщику в 2026
При выборе партнера обратите внимание на следующие технические характеристики. Я составил небольшую таблицу для наглядности, чтобы вы могли сравнивать предложения:
| Критерий | Устаревший подход (2023-2024) | Актуальный стандарт (2026) |
|---|---|---|
| Частота обновления | Раз в сутки (ночной расчет) | Real-time (менее 5 минут задержки) |
| Объяснимость | Отсутствует или в виде сырых логов | Интерактивный дашборд с факторами влияния |
| Интеграция | CSV выгрузка / ручной импорт | API, прямая интеграция с 1С, SAP, Bitrix |
| Работа с пропусками | Ошибка или удаление строк | Автоматическая импутация с учетом контекста |
| Поддержка | Email, база знаний | Чат с инженером, возможность ручной коррекции модели |
Как видите, разрыв между «старым» и «новым» огромен. Если поставщик предлагает вам решение, которое обновляется раз в сутки, в 2026 году это уже не инструмент конкуренции, а балласт. В условиях, когда цены на маркетплейсах меняются каждые 15 минут, суточный прогноз — это как смотреть в зеркало заднего вида, пытаясь объехать яму.
Тренд №3: Синтез внутреннего и внешнего контура данных
Третий тренд, возможно, самый важный для будущего. Лучшие системы прогнозирования больше не полагаются только на вашу внутреннюю статистику продаж. Они активно «пылесосят» внешний контур.
Что это значит на практике? Система анализирует:
- Данные о трафике в локациях (сотовые операторы, геосервисы).
- Социальные тренды и упоминания брендов в соцсетях и мессенджерах.
- Макроэкономические индикаторы (ключевая ставка ЦБ, инфляция, курс валют).
- Действия конкурентов (парсинг цен, наличие товаров).
В России этот тренд имеет свою специфику. Из-за ухода многих западных сервисов аналитики, российские поставщики были вынуждены создать собственные альтернативы парсингу и сбору данных. И, знаете что? В некоторых аспектах они стали даже лучше. Например, интеграция с данными Яндекс.Карт или 2ГИС дает невероятную точность в оценке пешеходного трафика, что критично для офлайн-ритейла.
Но тут есть подводный камень. Качество внешних данных varies wildly (сильно варьируется). Некоторые поставщики покупают дешевые датасеты сомнительного качества и выдают их за «Big Data». Как проверить? Попросите показать пример корреляции между внешним фактором и вашим спросом на исторических данных. Если корреляции нет или она натянутая — вас пытаются обмануть.
Также важен вопрос легальности сбора данных. В 2026 году регуляторы внимательно следят за тем, откуда берутся данные для обучения моделей. Убедитесь, что ваш поставщик использует только легальные источники (открытые API, договоры с агрегаторами), иначе вместе с точным прогнозом вы получите штраф от Роскомнадзора.
Практический гид: как выбрать поставщика и не потерять деньги
Итак, вы решили внедрить систему. С чего начать? Не с поиска вендора, а с аудита своих данных. Это банально, но факт: если у вас в учетной системе бардак, никакой ИИ не спасет. Garbage in, garbage out (мусор на входе — мусор на выходе). Проверьте, насколько полны ваши исторические данные, нет ли больших пробелов, корректно ли ведутся остатки.
Далее — формулировка задачи. Что именно вы хотите прогнозировать? Спрос на конкретный SKU? Общий товарооборот магазина? Потребность в персонале? Чем уже задача на старте, тем быстрее будет результат. Не пытайтесь «предсказать всё» сразу.
При общении с потенциальными поставщиками задавайте неудобные вопросы:
«Что будет, если наши данные изменят структуру?» (Проверка на гибкость архитектуры).
«Как быстро модель адаптируется к форс-мажору вроде закрытия моста или забастовки?» (Проверка на скорость реакции).
«Можем ли мы забрать модель и данные к себе, если решим расторгнуть контракт?» (Вопрос вендор-лока и прав собственности).
Последний пункт критичен. Многие компании попадают в ловушку, когда модель становится неотъемлемой частью облака поставщика, и миграция становится технически невозможной или экономически нецелесообразной. Требуйте в договоре пункта о передаче прав на дообученную модель или возможности экспорта весов модели в открытом формате (ONNX, PMML).
Реальный кейс: успех через сомнения
Хочу привести пример одной сети строительных магазинов в Поволжье. В начале 2025 года они стояли перед выбором: продлить контракт с дорогим западным вендором или перейти на российскую разработку. Западный вариант давал стабильность, но перестал развиваться. Российский обещал чудеса, но был «сырым».
Они пошли на риск, но с условием: гибридный этап. Полгода работали параллельно. Да, это стоило двойной лицензии. Но это позволило сравнить прогнозы в боевых условиях. Выяснилось, что российский алгоритм лучше предсказывал сезонные пики (весна/осень), учитывая местные погодные условия, но хуже работал с новинками ассортимента.
В итоге они не просто сменили поставщика, а заставили российского вендора доработать модуль работы с новыми товарами под их специфику. Сейчас, в 2026 году, их оборачиваемость запасов выросла на 22%, а уровень out-of-stock (отсутствия товара) снизился до минимума. Секрет успеха был не в технологии самой по себе, а в партнерском подходе и готовности заказчика участвовать в настройке.
Заключение: Прогноз на будущее
Рынок прогнозирования в режиме онлайн в России в 2026 году находится в точке бифуркации. С одной стороны — мощные технологические возможности, рост вычислительных мощностей и доступность данных. С другой — дефицит квалифицированных кадров, способных этим управлять, и риски регуляторного давления.
Мой личный прогноз: ближайшие два года мы увидим волну консолидации. Мелкие игроки, которые просто «натягивали» открытые библиотеки, исчезнут или будут поглощены крупными экосистемами. Останутся те, кто предлагает комплексный сервис: от чистки данных до внедрения и обучения персонала. Особую ценность приобретут компании, способные предложить не просто софт, а полный цикл аппаратно-программных решений с глубокой экспертизой в предметной области, подобно тому, как это делает ООО «Аньхуэй Чжихуань технологии» в секторе промышленной диагностики, обеспечивая надежность там, где цена ошибки измеряется человеческими жизнями и экологической безопасностью.
Главный совет напоследок: не ищите идеальную кнопку «Бабло». Такой не существует. Прогнозирование — это процесс, а не разовое действие. Это постоянный диалог между человеком и машиной. Выбирайте тех поставщиков, которые готовы вести этот диалог с вами на равных, а не тех, кто прячется за красивыми терминами и непрозрачными тарифами.
И помните: в мире, где изменения происходят быстрее, чем обновляются модели, самая ценная валюта — это не точность прогноза до четвертого знака после запятой, а скорость вашей реакции на ошибку. Тот, кто быстрее всех поймет, что прогноз неверен, и скорректирует курс, и выиграет эту гонку.
Удачи в построении ваших моделей. И пусть ваши данные будут чистыми, а инсайты — неожиданными.
Источники и использованные материалы: